这对你的产品意味着什么
每位客户都能存入
客户可以从任意受支持链上的任意代币建立持仓。你不必再上线一个只对少数提前做好准备的客户有效的按钮。
自定义并自留的费用
你可以对存入设置费用并自行保留,这让收益功能成为一条收入线,而不是一项需要你掏钱维持的留存功能。
无需组建 DeFi 团队
一套模式覆盖所有受支持的协议,因此接入第十个金库的成本与接入第一个大致相同。
提升每位客户的参与度
闲置余额意味着客户已经不再使用产品。而一个持仓意味着客户有理由回来查看。
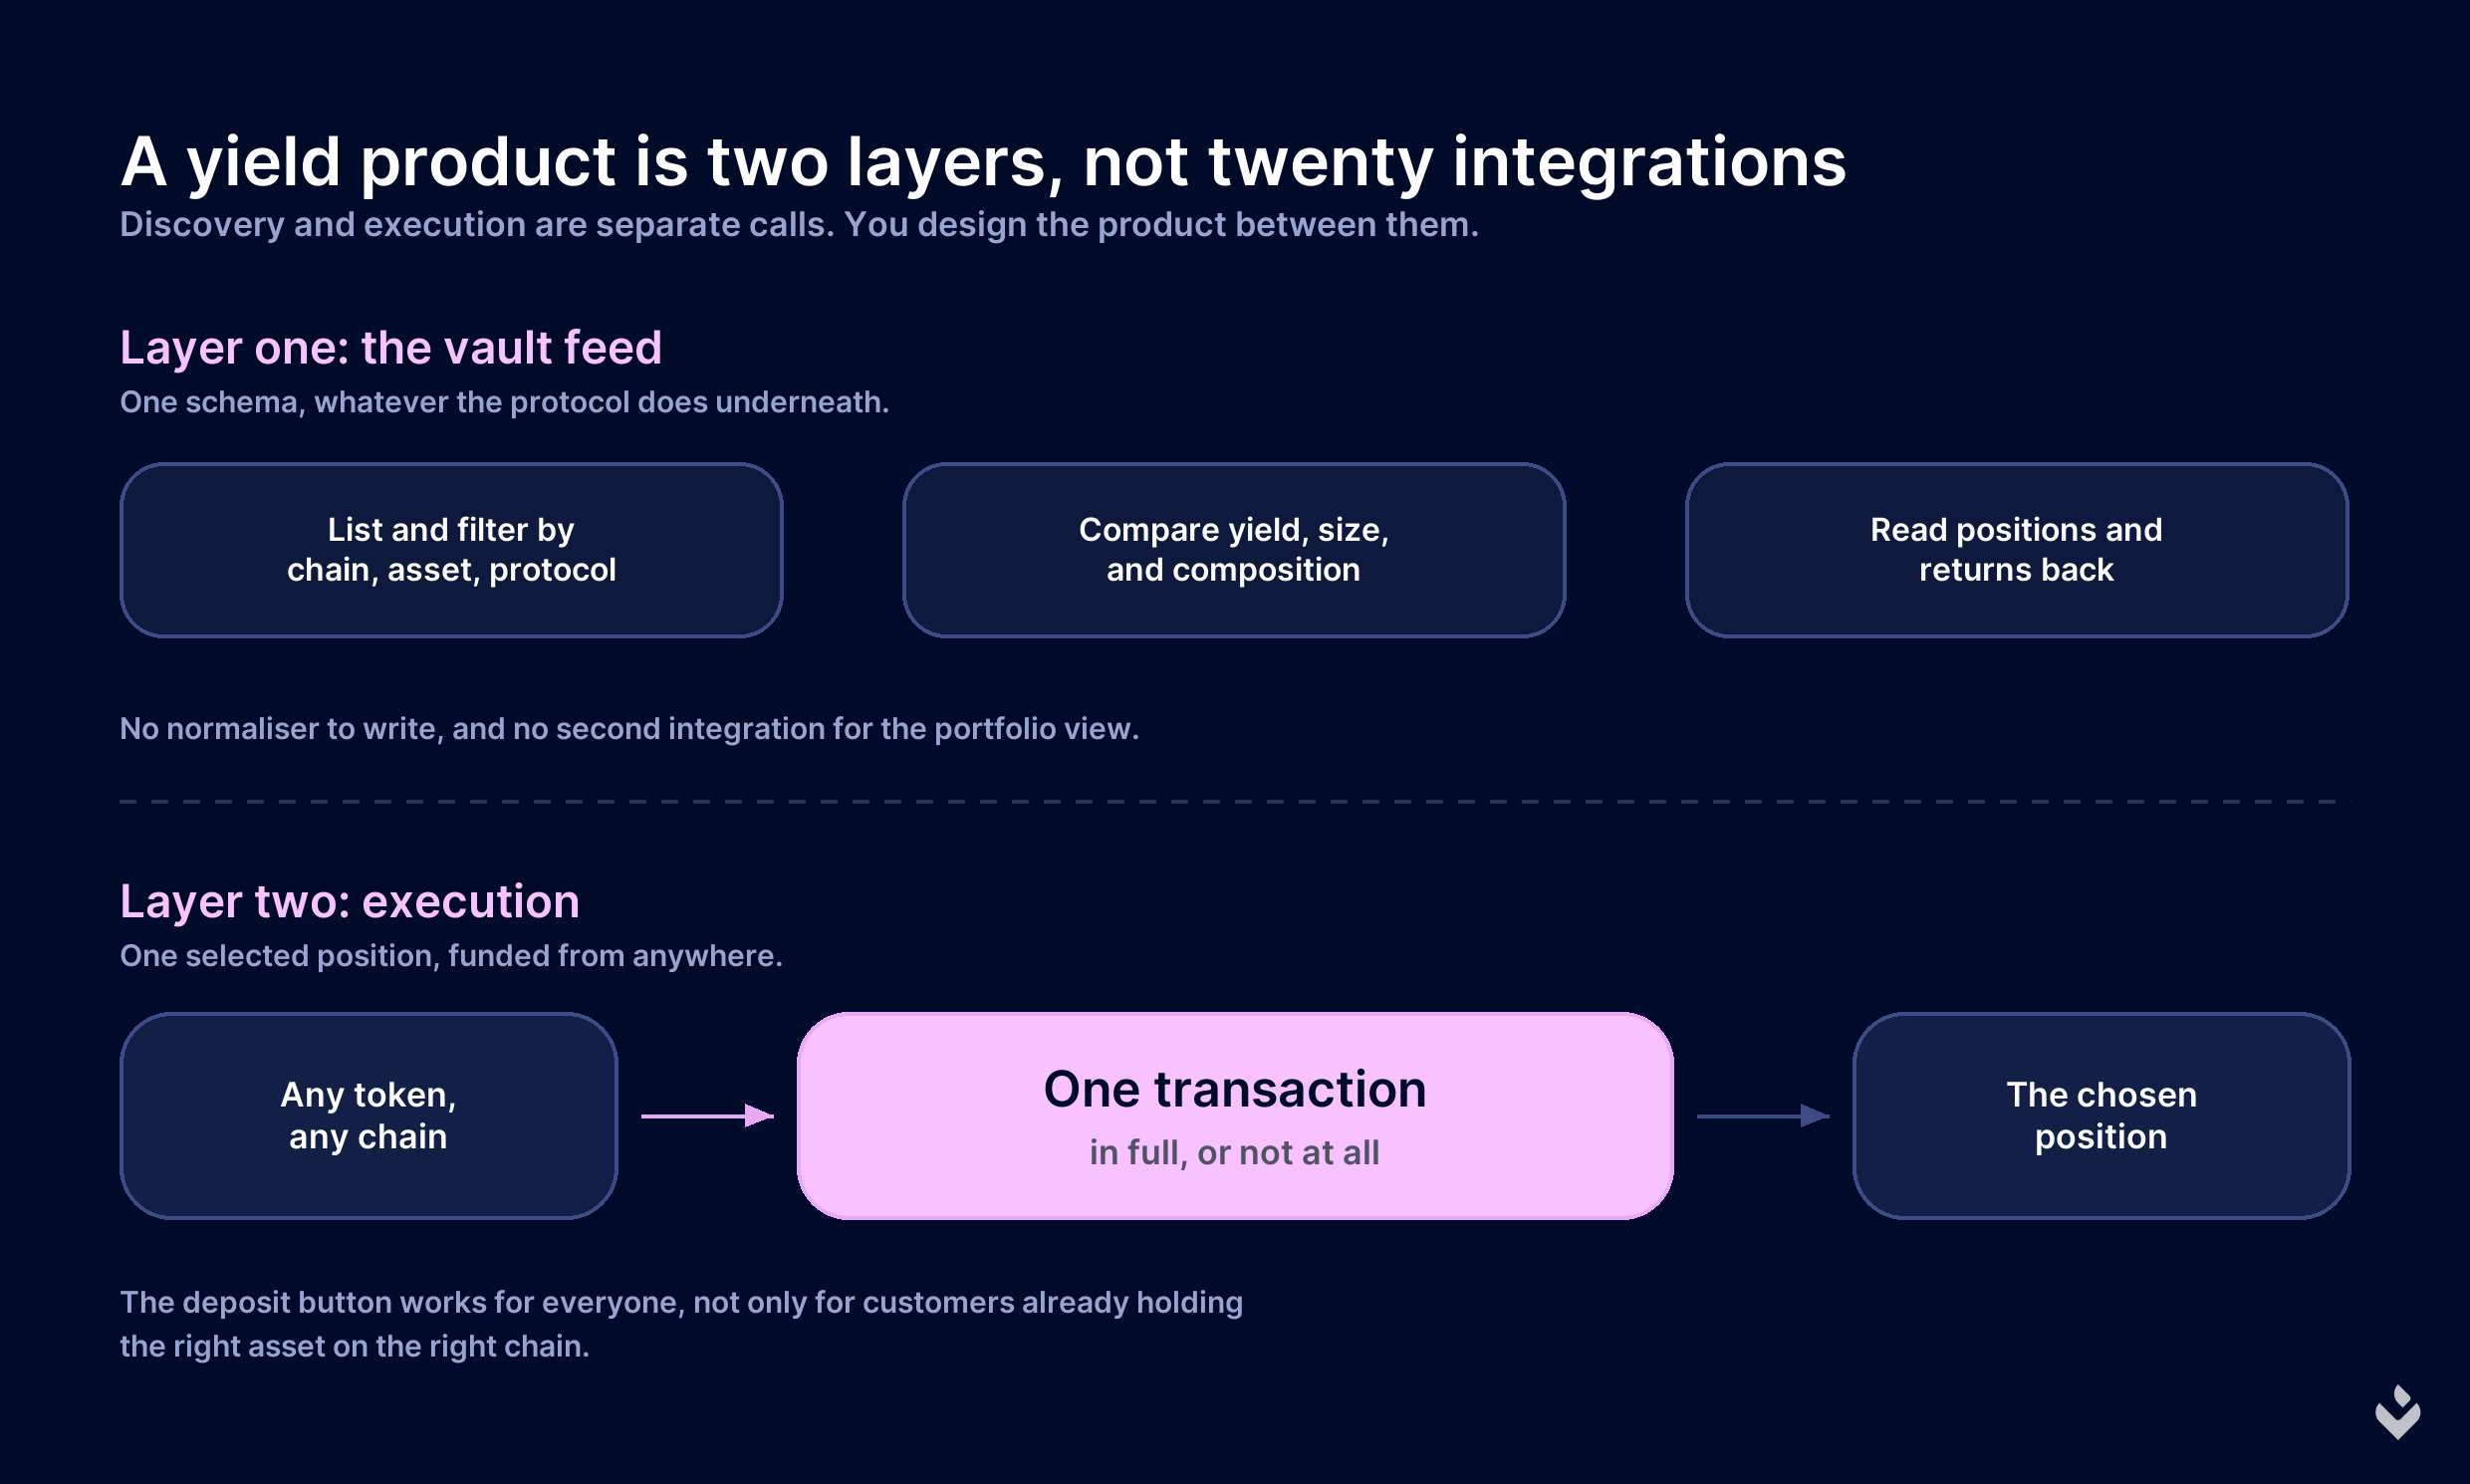
发现与执行是两个独立的调用。两者之间的产品由你来设计。
自行构建需要付出什么
以直接方式构建收益功能,意味着要逐个集成每个协议。每个协议都有自己的合约结构、自己的存入与收益核算方式,以及自己对持仓的定义。你需要手动将这一切标准化,接入下一个协议时再做一遍,并在该协议运行的每条链上重复一遍。 接下来是更难的那一半。客户想在一条自己没有任何资产的链上、用自己并不持有的资产建立持仓。要做到这一点,需要跨两条链完成一次交换、一次转账和一次存入。如果这些作为独立步骤执行,中途失败的客户就会停留在错误的链上,持有一种并非自己想要的资产,而这个后果要由你的支持团队来承担。 LI.FI Earn 将这个问题拆分为数据层和执行层,正是这种分离让你无需成为 DeFi 团队也能构建这款产品。第一层:了解有哪些可用选项
金库数据源以统一的模式返回来自受支持协议的持仓,无论底层协议内部如何运作。收益、规模和代币构成可以直接比较,这意味着你无需编写标准化程序即可进行排序和筛选。筛选
按链、资产或协议筛选,让列表反映客户实际持有的资产。
比较
收益、规模和构成采用统一模式,无需在不同协议之间整理数据。
追踪
客户的未平仓持仓和收益,以与展示选项时相同的结构读回。
第二层:让资金进入
执行由 Composer 负责。客户选择一个持仓,即可从任意受支持链上的任意代币完成存入。原子性保证的适用范围。 在单条链上,交换和存入在同一笔交易中执行,因此不存在客户只完成一半的状态。当资金来自另一条链时,源链交易会触发桥接,目标链上的操作在桥接结算后执行。每个阶段在其所在链上都是原子的,而整个流程是最终一致的,因此请通过状态接口追踪流程,而不要假设只有单一结果。
哪些仍由你掌控
LI.FI 提供的是基础设施,而不是产品。展示哪些协议、按什么顺序、附带怎样的风险披露、面向哪些客户,全部由你决定。变现也是如此:你可以对存入设置费用并自行保留。上线前需要做出的决定
发现与执行可能不一致
发现与执行可能不一致
数据覆盖范围取决于 LI.FI 同步管道已索引的内容,因此某个金库存在于受支持的协议上,并不能保证它会出现在数据源中。请让界面渲染你实际收到的数据源,而不是你预期的列表。
存入通过 Composer 执行,且只能通过 Composer
存入通过 Composer 执行,且只能通过 Composer
金库数据源负责发现和追踪。如果你把数据源当作执行入口来设计,就会很晚才发现这个缺口。
如何处理已发生变化的收益数字
如何处理已发生变化的收益数字
决定刷新频率、数字过时期间显示什么,以及客户点击存入时看到的数字是否就是你针对该决定所记录的数字。任何答案都可以。不做选择则会带来一场你注定赢不了的客服对话。
先确定披露立场,再确定协议列表
先确定披露立场,再确定协议列表
一旦你的产品展示了收益数字,无论附注中写了什么,客户都会将其理解为你的推荐。
从哪里开始
先构建发现功能,并以只读方式上线。一个按客户已持有资产筛选的持仓列表本身就很有用,而且能在你对任何协议做出承诺之前,告诉你应该优先接入哪些协议。然后再添加存入功能,先针对一种资产和一条链,再逐步扩展。Earn 快速入门
端到端完成金库选择、存入和持仓追踪。
Earn 的工作原理
数据管道、模式,以及数据源如何保持最新。
发现与存入
找到顶级金库,然后通过 Composer 为其注资。
受支持的协议
数据源当前覆盖的协议和链。
联系 LI.FI 团队
告诉我们你的客户持有哪些资产,以及你想构建的产品形态。我们会与你一起确定协议覆盖范围和费用模式。